基础知识
汇编的分类
如果按 CPU 架构分类,汇编语言主要分为 x86 系列和 ARM。
- x86 系列:
- 16 位(8086/8088):最经典的一集
- 32 位(x86):老式程序。在现在的 Windows 系统中,C 盘仍然能看到
Program Files (x86)文件夹。这些使用 x86 指令集的程序使用 32 位寄存器,且最大只能使用 4GB 内存。 - 64 位(x64):现代计算机的主流,寄存器扩展到了 64 位。
- ARM:主要在移动端和嵌入式领域应用。PC 和手机不统一使用 x86 架构的原因,或者说 ARM 的优势,在于能效方面。它具有精简的汇编指令集,待机或处理日常任务时功耗极低,适配手机体积小,供电有限的特点。并且 ARM 的设计允许手机厂商将大部分硬件(如 CPU,GPU,基带等)封装在一颗芯片内,设计方面高度灵活(卖 ip 也是经久不衰了)
汇编的组成
汇编语言发展至今,主要由以下三种指令组成:
- 汇编指令。它们直接控制 CPU 执行具体的操作,是机器码的助记符。如
MOV,ADD,SUB,JMP等。 - 伪指令。它们没有对应的机器码,是指导编译器工作的指令,不直接操控 CPU。如
db,end。 - 其他符号。用于完善汇编的可读性和运算的简便性,同样不直接操控 CPU,由编译器识别。如
+-*/和,;()等。
存储器和存储单元
存储器有很多,如集成在 CPU 内部的寄存器和三级高速缓存,以及内存(RAM)和外存(Disk)。存储器被划分为若干个存储单元,一个存储单元能存放 8bit 数据(1Byte)。计算机的存储单元上限不仅由存储器决定,还由 CPU 的地址总线宽度决定。对于 8086 架构,它的地址线宽度为 20,最大只能使用
CPU 的交互
当 CPU 与外部芯片进行交互时,必需三条信息:
- 存储单元(内存)或端口(外设)的地址,归类为地址信息
- (I/O)读写等,归类为控制信息
- 要发送或收取的内容,归类为数据信息
CPU 使用地址总线、控制总线和数据总线传输上述信息到外部芯片,或是从外部芯片收取信息。
地址总线
对于存储器芯片,我们现在知道了 CPU 是通过地址总线来定位存储单元的。在计算机中,一根导线通过高低电平区分状态。也就是说,n 根导线最多有
数据总线
数据线宽度越大,传输效率也就越高。对于拥有 16 宽度数据线的 8086CPU,它的传输效率相比于拥有 8 宽度数据线的 8088CPU 来说是翻倍的。一个字节有 8 位,现代 CPU 的数据线宽度已经达到了 64 位。而听起来违反直觉的是,USB 传输的位宽只有 1(串行传输)。虽然从数据上对比,USB 的传输效率似乎很慢,但事实上,串行传输的效率远大于并行传输,这得益于它极快的时钟频率。此外,显卡的 PCIE 槽同样是串行传输的。(好像说太多了?)
控制总线
控制总线的宽度决定了 CPU 能向外部发出多少指令。CPU 能发出的命令一般有以下几种:
- 读/写控制
- 时序控制
- 状态与响应
- 总线控制(秩序维护)
存储器芯片
存储器芯片从读写属性上可以分为两类:
- RAM(随机存储器),可读可写,断电擦除。
- ROM(只读存储器),只读不写,断电保存。
需要注意的是,硬盘(SSD/HDD)并不是 ROM,更不是 RAM。它独立于计算机外,属于外部存储设备。
RAM 多用于临时存放数据,不管是在 CPU,GPU 还是在外设的接口卡上。而 ROM 一般用于保存底层配置(BIOS),匹配其只读不写,断电保留的特性。在 CPU 的视角下,主内存、显存和存放 BIOS 的 ROM 等都是储存器,它们的存储单元都有独一无二的地址。正因如此,基于计算机硬件编程时,搞清楚地址分配空间是很重要的。
寄存器
通用寄存器
对于 8086 架构,其所有寄存器都是 16 位的。AX、BX、CX、DX 四个寄存器用于存放一般数据,被称为通用寄存器。类似的,x86 和 x64 架构中,寄存器数量分别提升到了 8 个(32bit)和 16 个(64bit)。它们都可以按位访问,如 RAX -> EAX -> AX -> AH/AL
mov 和 add
对于 mov ax,18 和 mov al,18,前者表示把 18 装进整个 ax 寄存器,后者表示把 18 装进 ax 的低 8 位。值得注意的是,如果试图执行 mov al,256,编译器会报错。如果强制执行,256(二进制 100000000)会被截断,只剩下后面的 8 个 0。mov ax,bx 表示将 bx 的数据复制到 ax 中。汇编代码的顺序好像有点反人类了吧,数据从右边流向左边。
add ax,8 表示将 ax 的数据加 8,add ax,bx 代表将 ax 与 bx 相加,存在 ax 中。当输入十六进制数时,要在末尾加 H。由于二进制与十六进制之间的特殊转化规则,写十六进制会更加直观一些。但是当十六进制数以字母开头时,不能直接写,要在数前加 0(如 mov ax,afh 是错的,要写 mov ax,0afh)
8086CPU 的寻址
8086CPU 有 20 位地址总线,但只有 16 位结构。为了解决这种冲突,其使用两个 16 位地址来合成一个 20 位的地址。但是如果直接将二者简单相加的话,也只有 17 位。因此,8086CPU 将物理地址分为两部分,分别为段地址和偏移地址,之后通过**物理地址 = 段地址 16+偏移地址 的方法寻址。这里的 16,在二进制下是左移 4 位,十六进制下是左移 1 位,即在末尾补 0 即可。CS 寄存器存放段地址,IP 寄存器存放偏移地址,二者都不能被 mov 指令直接修改。
根据段地址的数学特性和实际情况,段地址和段长度需要满足:
- 段地址一定能被 16 整除
- 段长度不能超过 64KB(16 位 CPU 下,
8086CPU 的命令执行
从电脑开机,到敲下汇编代码,再到代码被 CPU 执行,大致经过了以下步骤:
- 刚开机内存里什么也没有,8086CPU 在通电的一瞬间,硬件电路会将 CS: IP 强制设置为特定地址,其对应着一块 ROM,烧录着 BIOS。BIOS 运行后,它会去硬盘的引导扇区作引导(如 MBR/GPT 引导),从而启动操作系统。
- 假如只有两条指令,分别是
mov ax,1和add ax,1,汇编编译器会把这些代码翻译成机器码,之后打包成可执行文件,存放在硬盘中。当运行这个程序时,操作系统在内存中开辟一块空间,把机器码复制到这片空间里,给出第一条指令的位置。最后,操作系统强行将 CS 和 IP 的值修改为第一条程序的起始地址。 - CPU 从 CS: IP 指向的内存单元读取指令,读取的指令进入指令缓冲器。
- 自动计算所读取指令的长度,IP 移位到下一条指令的位置,指向下一条指令。注意,IP 移动是先于指令执行的。这种设计避免了跳转指令(如
JZ)导致的地址错乱,也提升了 CPU 的运行效率。 - 执行指令,转到步骤 3,重复这个过程。
修改 CS、IP 的指令
前面提到,mov 指令不能用来修改 CS 和 IP 寄存器。若想修改,可以使用 jmp 指令。如果想同时修改 CS 和 IP,可用形如 jmp 段地址:偏移地址 的指令完成。若只想修改 IP,可以先给某个通用寄存器(如 ax)赋值,再用 jmp ax 来跳转到指定的地址。但是计算地址太麻烦,这个时候可以使用转向标号的方法:
1 | |
为什么 jmp s 在前,而 s: add ax,2 在后?这种现象被称为 前向引用。汇编器在阅读这段代码时,会先选择性忽略 s 的具体内容。直到读到 s 代表的指令后,汇编器将地址偏移计算完毕,再在第二遍扫描中把 s 的偏移填进去,类似于 python 的 new_list = [2*x for x in list],其中 2*x 也是对 x 的前向引用。
运行汇编程序
我用的是 VSCode 的扩展插件 MASM/TASM 和 x86 and x86_64 Assembly。
让 AI 写一段 hello world:
1 | |
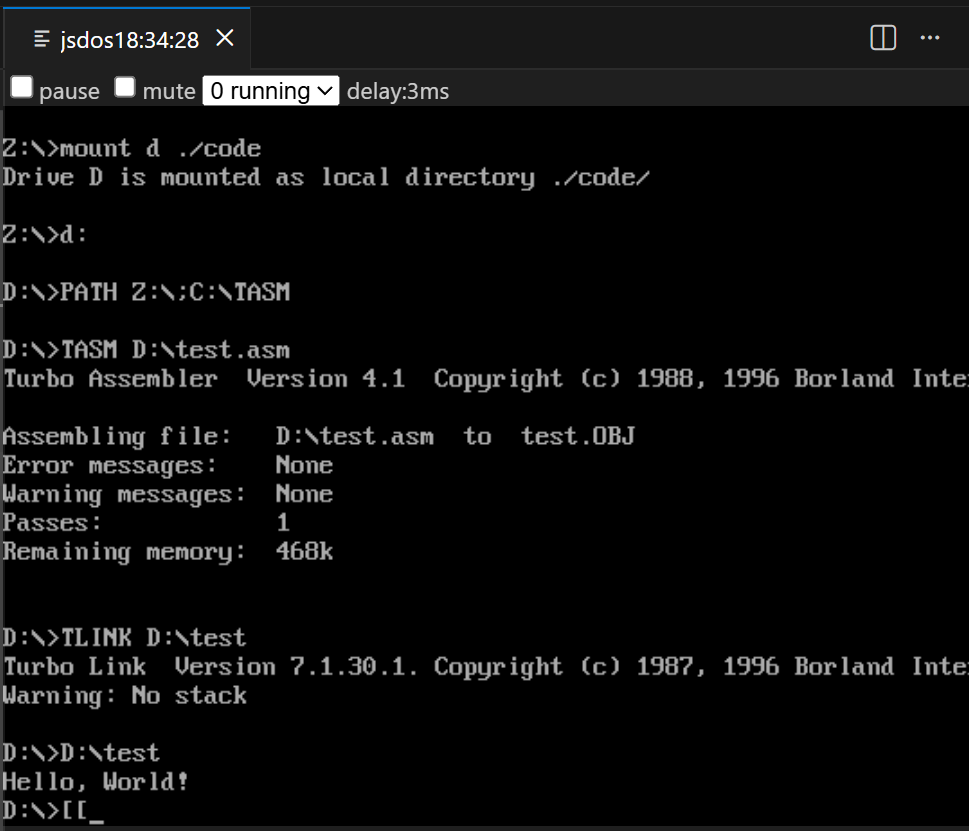
运行出来是这样的:
(真是老东西了)